SGLang
伯克利团队研发的结构化大模型推理加速引擎,独创 RadixAttention 实现跨请求跨轮次 KV 缓存自动复用,吞吐量超越 vLLM。
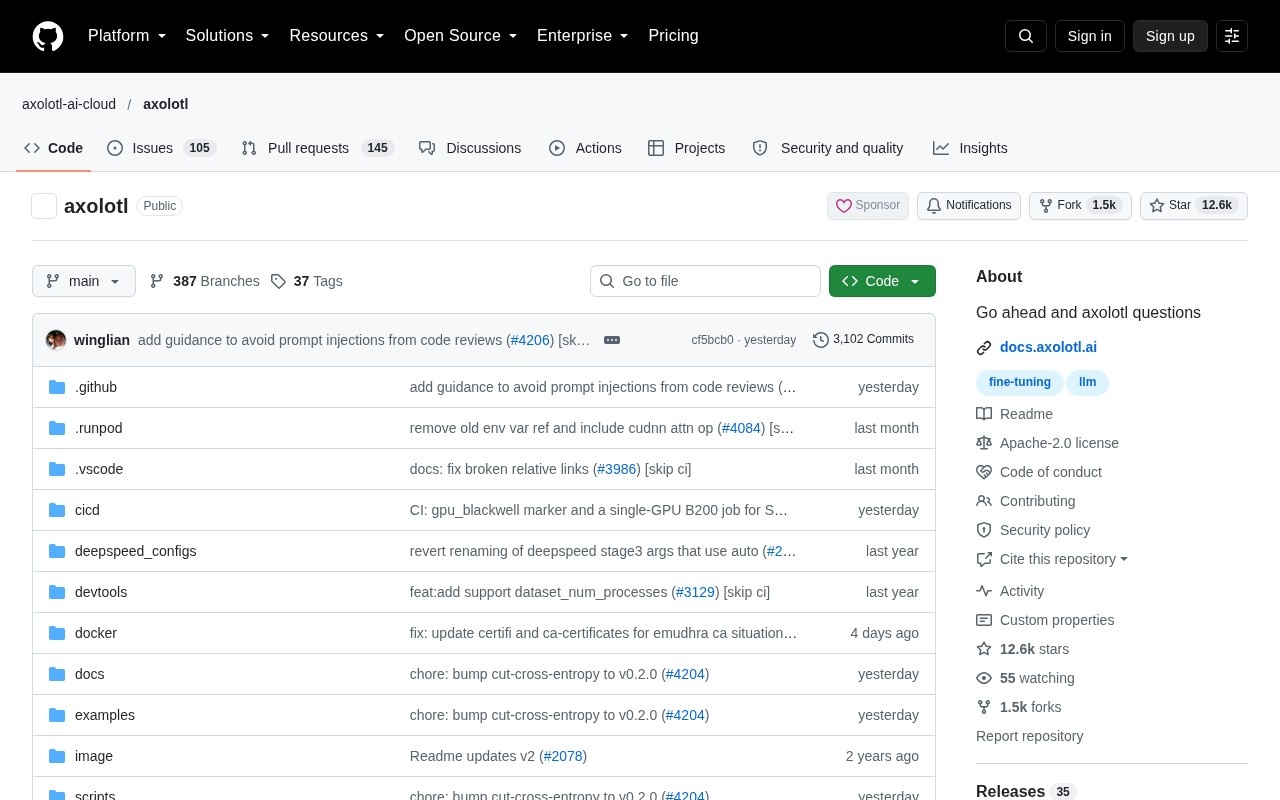
开源界最受推崇的大模型一站式微调利器,用极简 YAML 配置文件搞定 LoRA、QLoRA、DPO 与长上下文 FlashAttention。
 Axolotl
开源大模型微调工程的集大成者。传统微调需要手写繁杂脆弱的 PyTorch 训练脚本,而 Axolotl 将所有前沿微调技术(如 QLoRA 4-bit 量化训练、FlashAttention-2、DeepSpeed ZeRO-3、DPO 直接偏好对齐)封装为标准化的 YAML 配置。只需修改几行参数,即可在单张消费级显卡上开跑微调。
accelerate launch -m axolotl.cli.train examples/llama-3/lora.yml
无需手写复杂训练循环,纯配置文件驱动工业级微调
第一时间适配业界最新微调算法(如 DPO、ORPO、KTO)
完美结合 Accelerate 与 DeepSpeed 实现集群高效扩展
Hugging Face 上大量顶级微调开源权重均产自该框架