ComfyUI
全球最强大、最灵活的节点式(Node-Based)Stable Diffusion 与 FLUX 视觉生成工作流引擎。
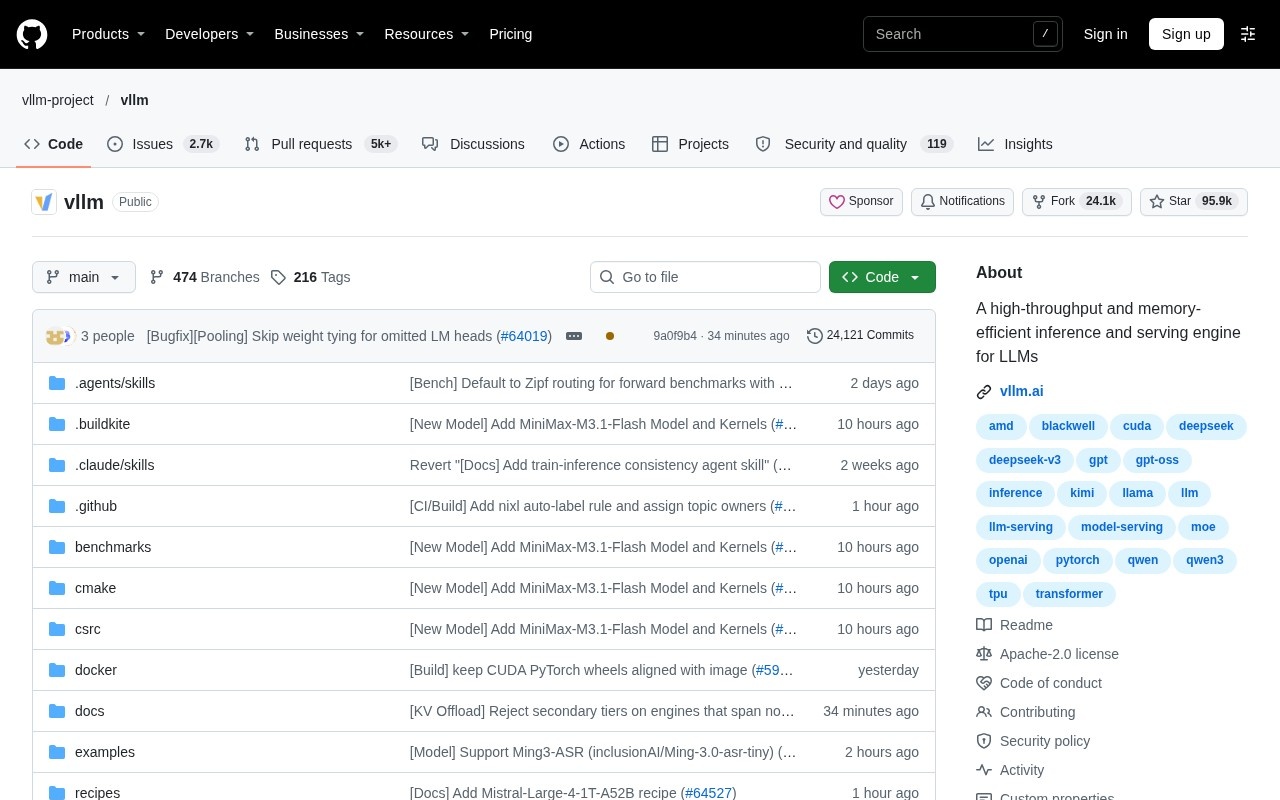
伯克利团队研发的高吞吐、低显存消耗的大模型推理服务引擎,独创 PagedAttention 机制,被全球云厂商奉为推理基准。
 vLLM
vLLM 是大模型推理工程历史上最具革命性的突破。针对大模型推理中 KV 缓存占用显存碎片化严重的问题,发明了类似操作系统虚拟内存分页的 PagedAttention 算法,吞吐量相较 HuggingFace 原生推理暴涨 14-24 倍,直接重构了全球 AI 基础设施的成本结构。
docker run --gpus all -p 8000:8000 vllm/vllm-openai:latest --model meta-llama/Meta-Llama-3-8B-Instruct
单卡并发处理请求数相较传统方案提升数十倍
彻底消除 KV Cache 显存碎片,近乎 100% 显存利用率
原生提供与 OpenAI 完全一致的 API 协议接口
全球知名云服务商与独角兽大模型标配基础设施