llama.cpp
纯 C/C++ 打造的极致轻量化 LLM 推理框架,零外部依赖,让大模型在 Mac M系列、普通 CPU 与树莓派上狂飙。
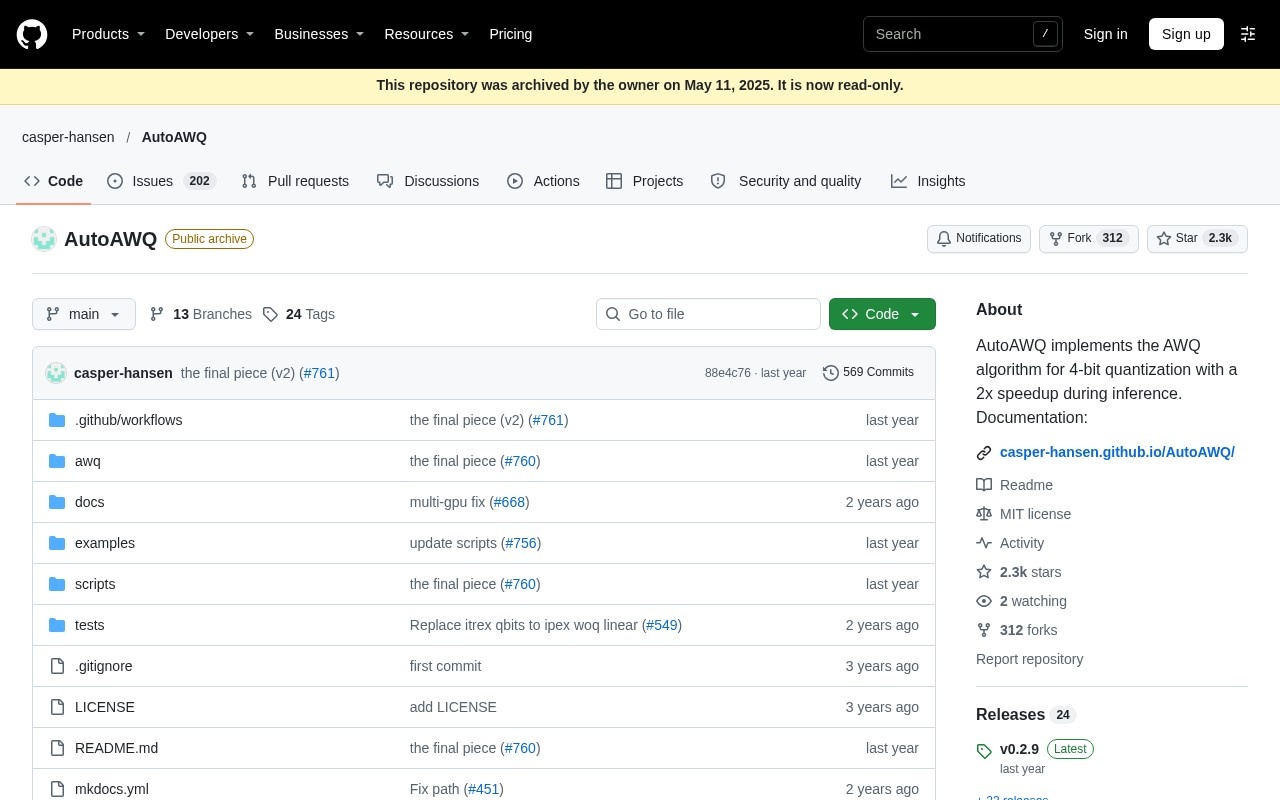
基于 MIT 激活感知权重(AWQ)算法的 4-bit 极限模型量化库,在保持高生成精度的同时实现推理吞吐狂飙。
 AutoAWQ
推动 4-bit 工业量化落地的中流砥柱。不同于对所有权重一视同仁的粗暴截断,AWQ 算法敏锐地发现:只有约 1% 的显著权重对大模型的推理准确率起决定性作用。AutoAWQ 通过保护这 1% 的关键通道,实现了 4-bit 极低显存量化,且几乎完全保持了原版 16-bit 浮点数的智能逻辑水平。
pip install autoawq && python -c 'import awq; print(awq.__version__)'
只保护 1% 核心显著权重,实现极高质量的 4-bit 极限压缩
各大生产级推理框架原生第一梯队硬核支持其量化内核
原先需要 2 张昂贵显卡的模型,量化后单卡轻松容纳
被全球众多企业部署私有化大模型时选为默认量化格式