AutoAWQ
基于 MIT 激活感知权重(AWQ)算法的 4-bit 极限模型量化库,在保持高生成精度的同时实现推理吞吐狂飙。
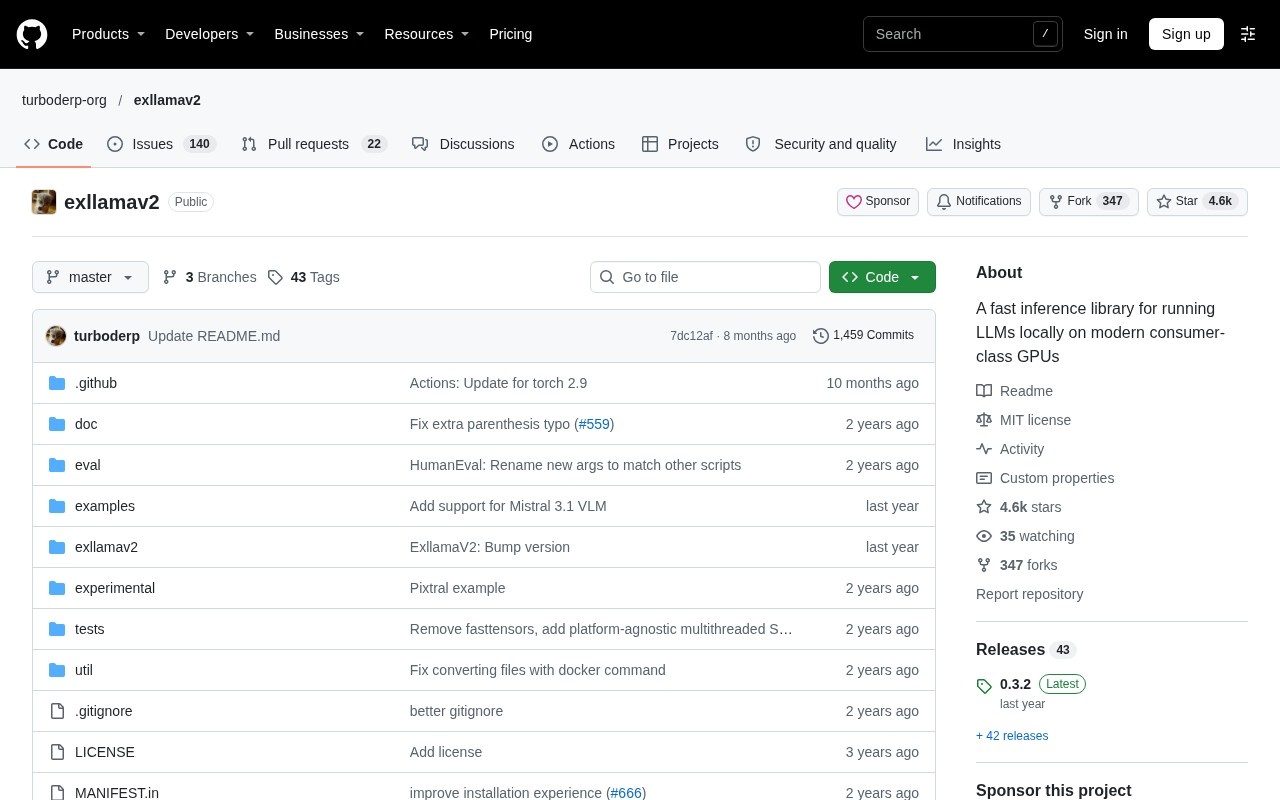
专为 NVIDIA 现代架构显卡打造的极速推理引擎,自研 EXL2 量化格式,在单卡消费级显卡上实现每秒上百 Token 狂飙。
 ExLlamaV2
 是专为追求极限速度的硬件发烧友打造的推理引擎。针对 NVIDIA Ada/Ampere/Turing 架构的 CUDA 核心进行了微观层面的汇编级重写。独创的 EXL2 量化格式支持任意位宽(如 2.2 到 8.0 bits)的无级量化,单张 RTX 4090 推理 70B 大模型时依然保持惊人的生成速度。
pip install exllamav2 && python test_inference.py -m /path/to/model
单卡生成速率冠绝群雄,轻松突破 100+ tokens/s
支持任意小数位宽量化,将显存挤压至最后一兆字节
针对长上下文推理显存优化极深,拒绝 OOM
本地高负载生产推理集群的核心利器